ChatGPT, Claude, Perplexity und Google lesen Ihre Website längst mit, nicht nur die klassische Google-Suche. Viele Betreiber haben deshalb einen Schalter entdeckt, den Cloudflare seit einiger Zeit anbietet: „KI-Crawler blockieren“. Ein Klick, und die Bots sind draußen. Klingt vernünftig. Für die meisten Firmenwebsites ist es trotzdem die falsche Entscheidung. Warum, und was stattdessen sinnvoll ist, zeigen wir an unserer eigenen Domain.
Nicht jeder KI-Bot will dasselbe
Hinter dem Sammelbegriff „KI-Crawler“ stecken sehr unterschiedliche Besucher:
- Antwort-Bots rufen eine Seite in dem Moment ab, in dem jemand ChatGPT, Claude oder Perplexity eine Frage stellt. Die Antwort nennt Ihre Seite meist als Quelle, mit Link. Das ist Sichtbarkeit, oft sogar ein Besucher.
- Such-Bots bauen den Index auf, aus dem diese Antworten schöpfen, ähnlich wie der Googlebot für die klassische Suche.
- Trainings-Bots sammeln Inhalte, um künftige Modelle zu trainieren. Einen direkten Besucher bringt Ihnen das nicht, langfristig aber womöglich, dass ein Modell Ihre Marke und Ihr Angebot „kennt“.
- Aggressive Scraper laden viel, nennen Sie nirgends und belasten nur den Server.
Wer alles in einen Topf wirft und sperrt, verschwindet aus den Antworten der KI-Assistenten. Gerade dort fragen aber immer mehr Menschen, bevor sie eine Website überhaupt besuchen.
Was wir auf mignuti.com gemacht haben
Wir haben die Frage für unsere eigene Domain durchgespielt und uns bewusst entschieden: Antwort-, Such- und Trainings-Bots dürfen rein, einige aggressive Bots ohne erkennbaren Nutzen bleiben draußen. Unsere Inhalte sind öffentliche Marketingtexte ohne personenbezogene Daten, und wir wollen gefunden werden, auch von KI.
Dabei sind uns drei Dinge aufgefallen, die man vorher wissen sollte:
- Cloudflare kann Ihre robots.txt überlagern. Die Einstellung „Managed robots.txt“ setzt eigene Regeln vor Ihre Datei. Im kostenlosen Tarif war das bei uns ein festes Trainingsverbot, das wir nicht wählen konnten, und dazu widersprüchliche Regeln. Wir haben die Einstellung abgeschaltet. Seitdem gilt die robots.txt, die wir selbst pflegen.
- „Fehlgeschlagene Anfragen“ sind nicht immer echte KI-Bots. In der Auswertung von Cloudflare tauchten erfolglose Abrufe unter bekannten Bot-Namen auf. Ein guter Teil davon waren Scanner, die sich nur als bekannte Bots ausgeben. Wer daraus voreilig neue Sperren ableitet, sperrt am Ende die Falschen.
- Kleine Lücken fallen erst in der Auswertung auf. KI-Assistenten fragten bei uns zum Beispiel nach einer Sitemap unter der klassischen Adresse, die es so nicht gab. Eine einzige Weiterleitung hat das behoben.
Und Pay per Crawl?
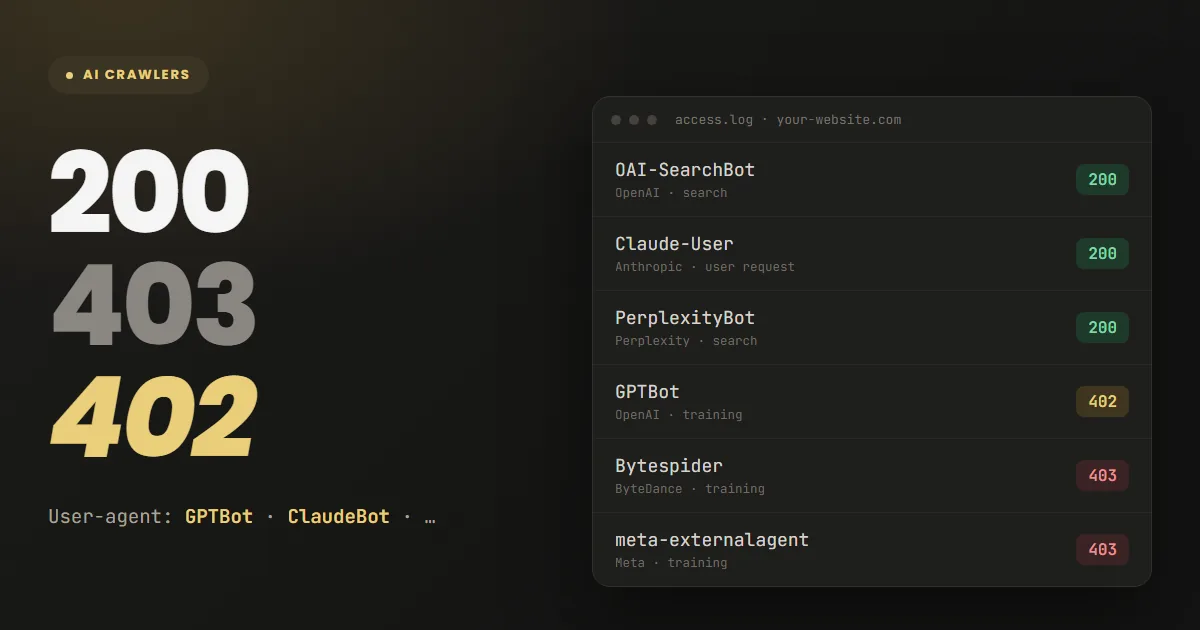
Cloudflare bietet inzwischen an, dass KI-Crawler pro Abruf bezahlen. Wer nicht zahlt, bekommt statt der Seite die Antwort „402 Payment Required“ mit einem Preis. Das ist spannend für Seiten mit sehr viel wertvollem Inhalt, etwa Fachportale, Verlage oder große Produktdatenbanken. Für eine typische Firmenwebsite sind die Beträge klein, und die Sichtbarkeit in KI-Antworten ist meist mehr wert. Das Verfahren ist zudem noch neu. Wir würden es nur dort einsetzen, wo die Rechnung aufgeht.
Unsere Empfehlung in vier Schritten
- Erst schauen, dann sperren: Welche Bots kommen wirklich, welche erfolgreich, welche nicht?
- Ziel festlegen: Wollen Sie in KI-Antworten auftauchen? Gibt es Inhalte, die Sie schützen oder verkaufen möchten?
- Eine Quelle für die Regeln: entweder Ihre robots.txt oder Cloudflares verwaltete Datei, nicht beides gegeneinander.
- An Ihre eigenen Dienste denken: Ein Website-Chatbot, ein Monitoring oder ein SEO-Werkzeug crawlt Ihre Seite ebenfalls. Wer pauschal sperrt, legt sie mit lahm. Für unseren eigenen Chatbot-Crawler erklären wir offen, wie man ihn freigibt oder sperrt.
Wenn Sie das nicht selbst auseinandersortieren möchten: Wir prüfen Ihre Website, empfehlen eine Linie und richten sie ein. Mehr dazu auf unserer Seite KI-Crawler & KI-Sichtbarkeit.